چرا Jev را کنار مدل زبانی سیمرغ گذاشتیم
تجربهٔ فنی سیمرغ با Jev از TypeSafe: چطور تصمیمهای ساختیافته، احتمال قابلسنجش و سرعت، در کنار توانایی گفتوگوی مدل زبانی به دستیار قابلاتکاتری میرسند.
سیمرغ
گفتوگویی که به کار روزانه وصل است
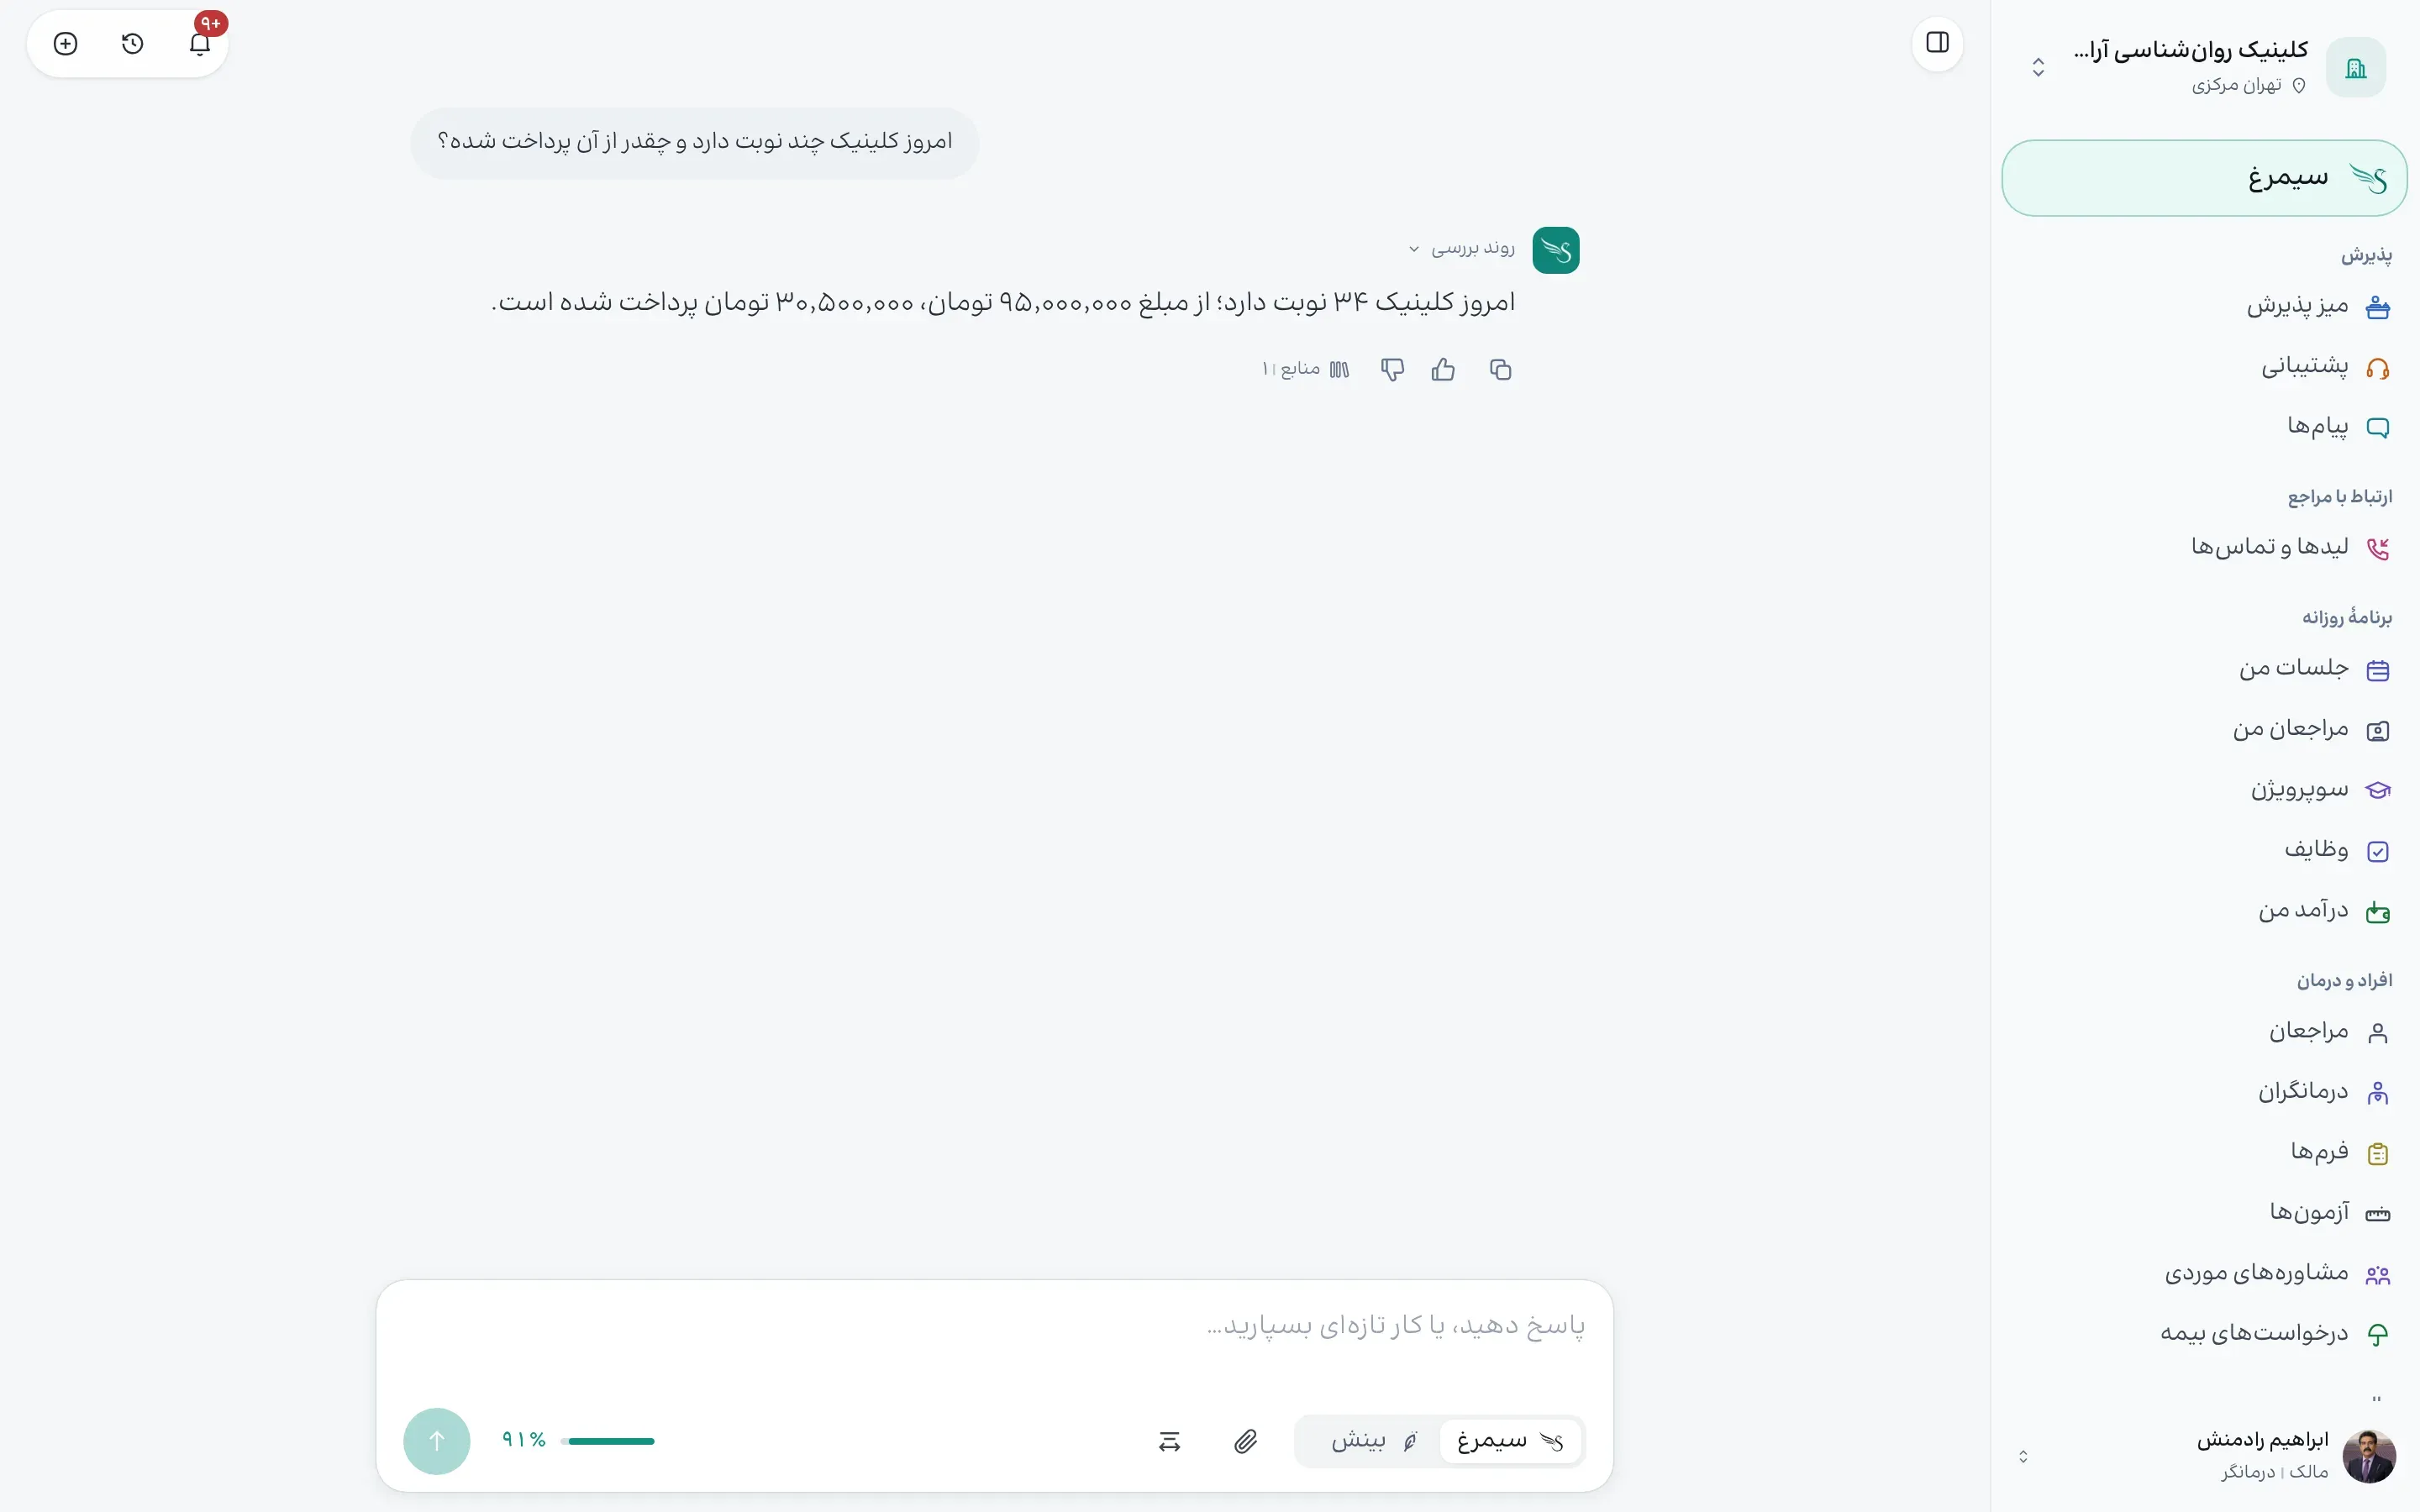
در سیمرغ، گفتوگو به برنامه و اطلاعات مجاز کلینیک وصل است. کاربر میتواند دربارهٔ کارش بپرسد، ابهام را روشن کند و نتیجه را در خود محصول ببیند.
دیدن سیمرغ←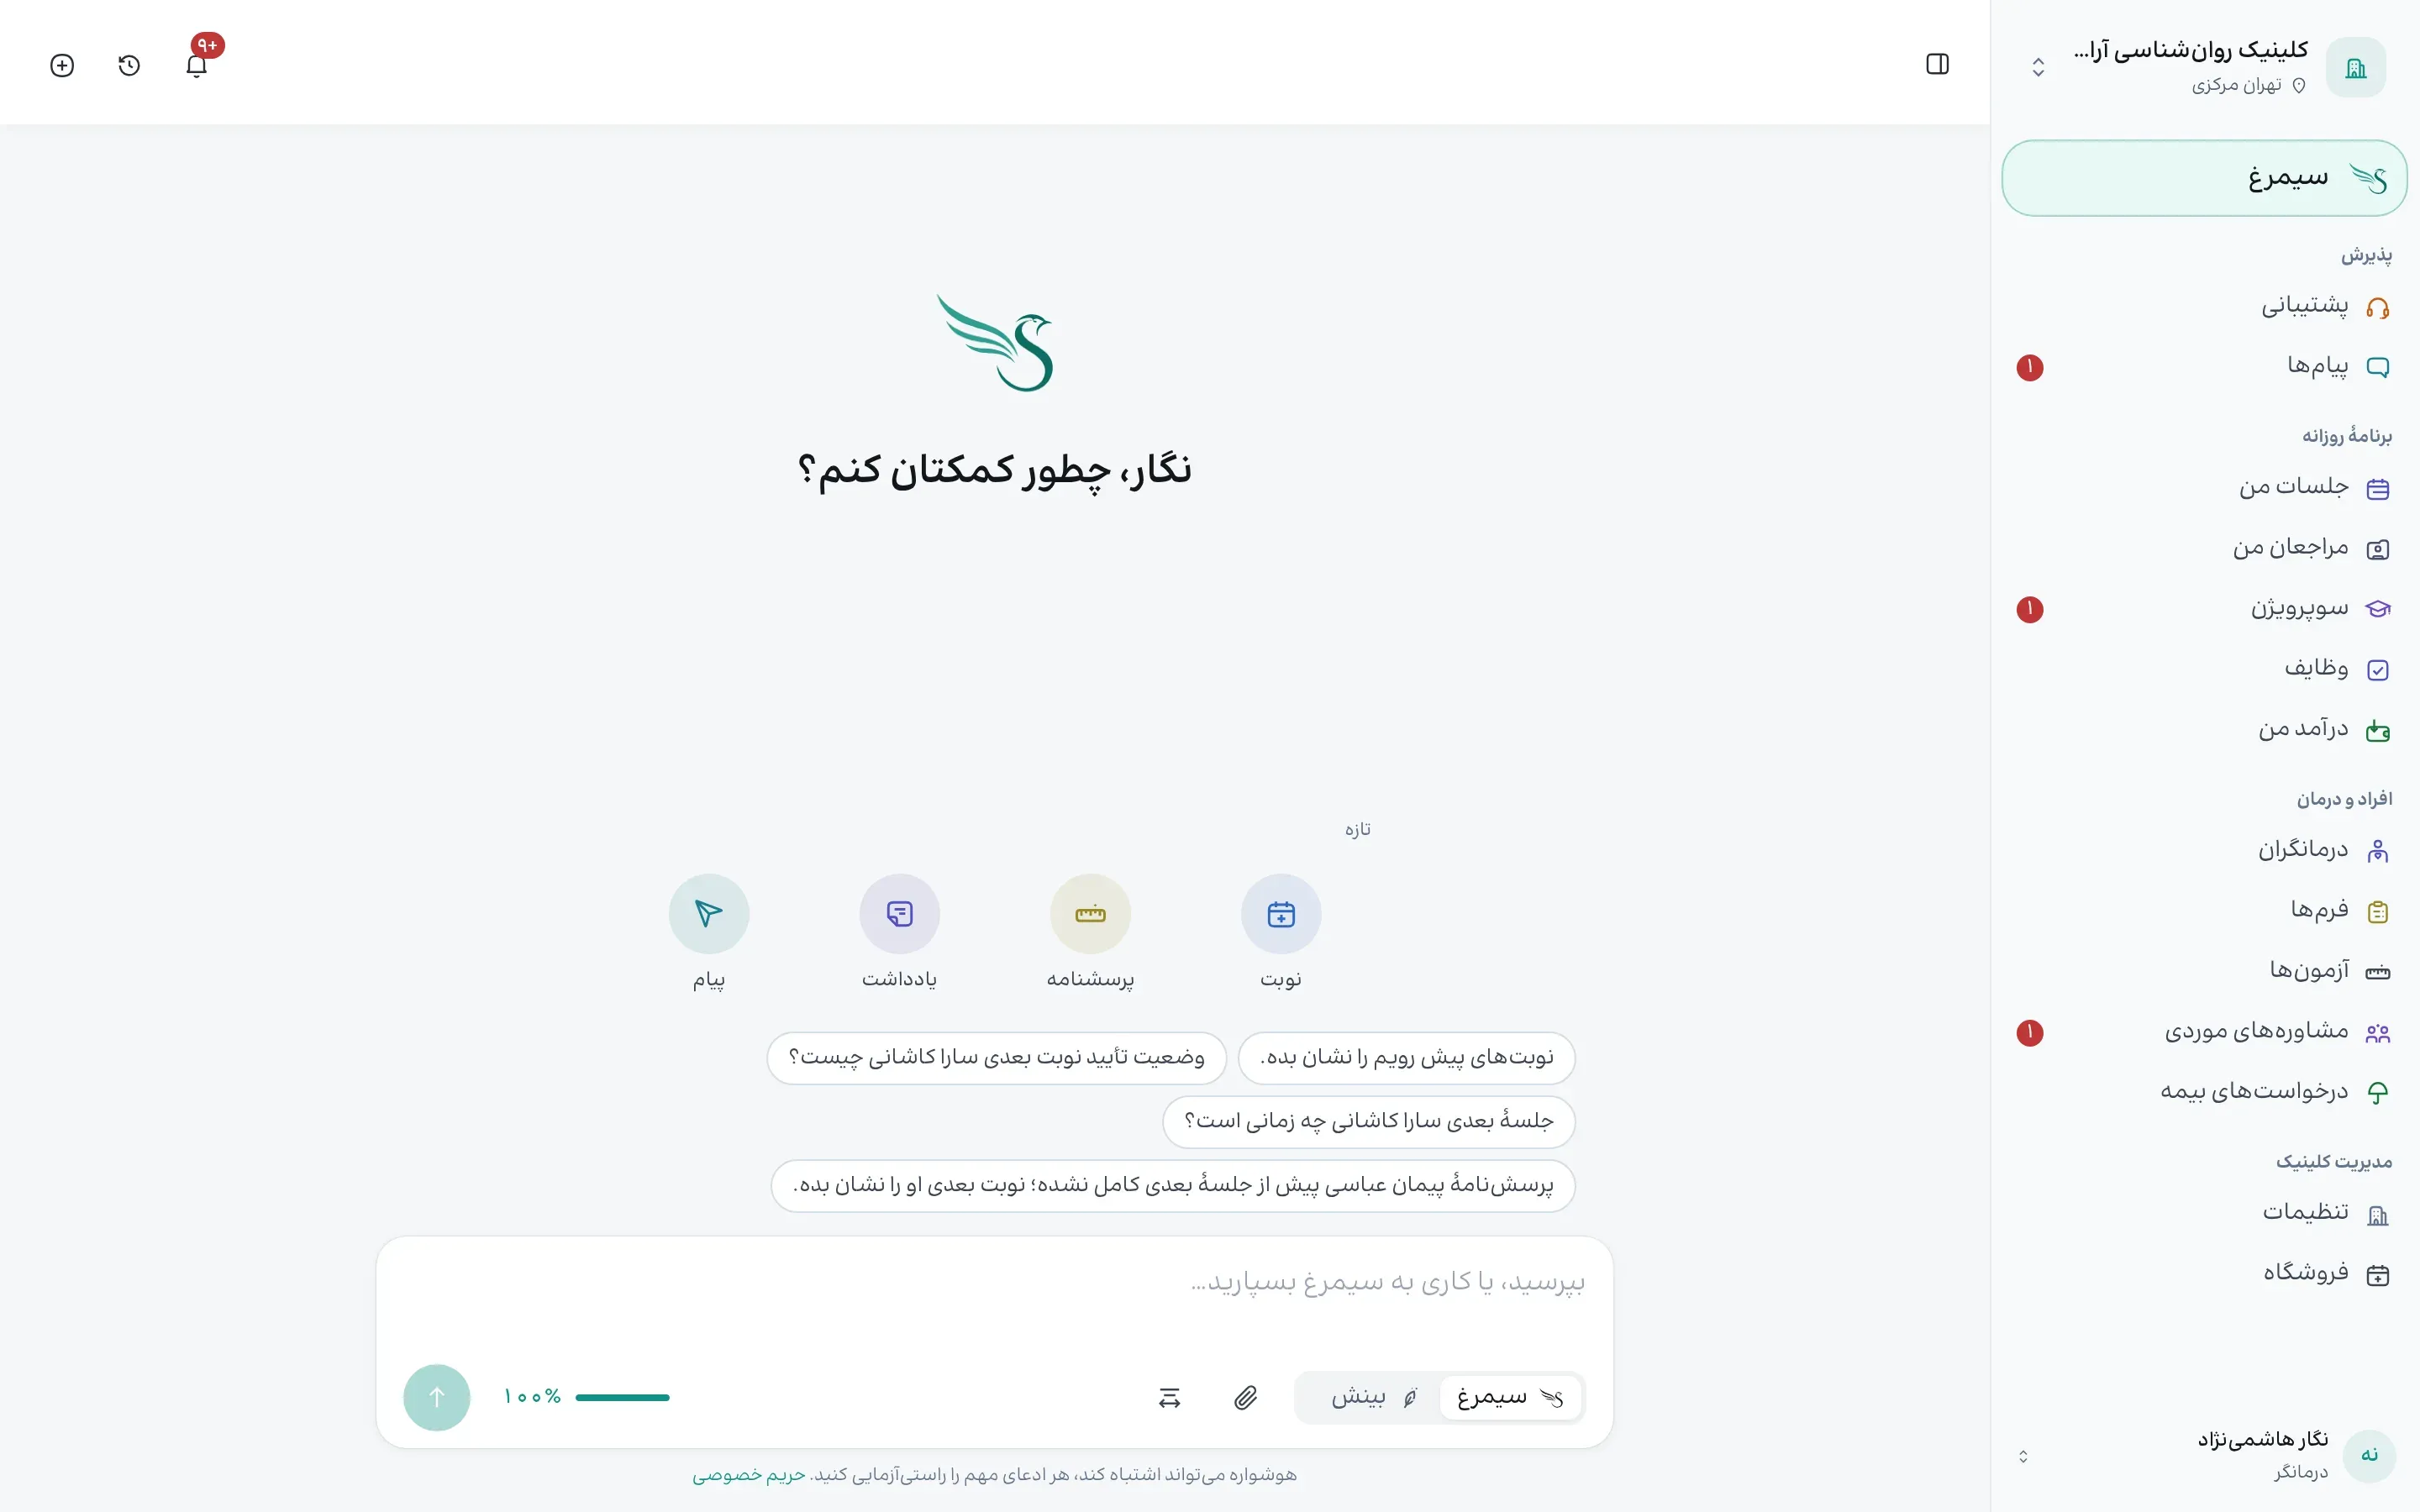
پذیرش مینویسد: «نوبت فردای سارا را ببر ساعت ۱۶.» یک دستیار زبانی میتواند پاسخ روانی بدهد. اما ارزش این پاسخ به چند چیز دیگر بستگی دارد: کدام سارا؟ کدام نوبت؟ آیا ساعت موردنظر آزاد است؟ و اگر منظور کاربر روشن نیست، دستیار چقدر زود متوجه این ابهام میشود؟
اینها بخش بزرگی از کار ما روی سیمرغ در هفتهٔ اخیر بودند. دستیار اکنون کارهایی مثل ثبت ورود، رزرو و جابهجایی نوبت و فرستادن پرسشنامه را در گفتوگو انجام میدهد؛ برای ابهام سؤال میپرسد و برای کارهایی که نیازمند تأییدند، پیشنهاد مشخصی نشان میدهد. در این مسیر، Jev از TypeSafe را کنار مدل زبانی قرار دادهایم تا سنجش تصمیمهای محدود و عدمقطعیتشان سهم مستقلی در رفتار دستیار داشته باشد.
برداشت ما از این تجربه این است: در یک نرمافزار بزرگ، برای تصمیمهایی که به عمل منتهی میشوند، ثبات رفتار، احتمال قابلسنجش و سرعت معمولاً از زیباترشدن متن اولویت بالاتری دارند. کیفیت زبان همچنان لازم است؛ کسی نباید برای فهمیدن پاسخ دستیار زحمت بکشد. اما پس از رسیدن به زبان روشن و درست، بهبود بعدی را باید در انجام قابلاتکای کار جستوجو کرد.
Jev مدلی از خانوادهای است که TypeSafe آن را «System One» مینامد. ورودی زبانی را میفهمد و به پرسشهایی با فضای پاسخ مشخص جواب میدهد: انتخاب یک گزینه، امتیازدادن بر اساس معیار، یا سنجیدن یک گزاره. خروجی آن مقدار ساختیافته و اطلاعات احتمالی است؛ برای نوشتن پاسخ گفتوگو یا توضیح استدلال طراحی نشده است. این تعریف را میتوان در مستندات رسمی Jev دید.
برای نمونه، در یک سامانهٔ پشتیبانی میتوان پرسید پیام به کدام دسته تعلق دارد. وقتی احتمال میان چند دسته پخش شده باشد، نرمافزار سیگنالی برای مکث و روشنکردن مسئله دارد. وقتی شواهد روی یک دسته متمرکز باشند، مسیر رسیدگی روشنتر میشود. ارزش این خروجی برای نرمافزار در همین قابلیت استفاده از عدمقطعیت است.
مدلهای زبانی معمولی هم میتوانند خروجی ساختیافته بدهند. در مقایسهٔ خودمان نیز مدل زبانی را با قالب سختگیرانهٔ JSON سنجیدیم. بنابراین انتخاب Jev صرفاً برای داشتن چند فیلد مرتب نبود. درستی قالب، درستی تصمیم و شناخت عدمقطعیت، سه معیار جدا هستند. ممکن است یک پاسخ کاملاً مطابق قالب باشد و گزینهٔ اشتباهی را انتخاب کرده باشد.
همین تمایز دربارهٔ عبارت «type-safe» هم لازم است. محدودبودن پاسخ به گزینههای تعریفشده، انتخاب درست را تضمین نمیکند. اگر اطلاعات ناقص باشد یا گزینهها مسئله را خوب بیان نکنند، یک مدل تصمیمگیری هم میتواند اشتباه کند. TypeSafe نیز در توضیح System One تصریح میکند که کالیبراسیون در مجموعهای از پیشبینیها سنجیده میشود و تضمینی برای درستبودن یک پاسخ مشخص نیست.
کالیبراسیون یعنی احتمالهای اعلامشده با نتیجههای مشاهدهشده تناسب داشته باشند. برای مثال، در مجموعهای کافی از پیشبینیهای مشابه که احتمال درستیشان حدود ۹۰ درصد برآورد شده، انتظار داریم حدود ۹۰ درصد درست باشند. این انتظار باید در زبان و کاربرد خودمان آزمایش شود. عددی که در یک مسئله خوب رفتار میکند، خودبهخود برای مسئلهای دیگر قابل اعتماد نمیشود.
یک نکتهٔ فنی ظریف هم اینجاست: در پاسخهای انتخابی Jev، توزیع probabilities و مقدار confidence یک چیز نیستند. طبق مستندات اطمینان TypeSafe، دومی خلاصهای از شکل توزیع است. نباید هر عددی با نام «اطمینان» را مستقیماً درصد موفقیت کل عملیات دانست. یک کار ممکن است چند ابهام داشته باشد و خطای هرکدام نتیجه را عوض کند.
در ارزیابی داخلی ما، پیامهای فارسی ساختگی و وضعیت یک کلینیک فرضی مبنای مقایسه بودند. Jev و مدل زبانی با ورودیها و گزینههای یکسان سنجیده شدند. مدل زبانی در بعضی سنجههای دقت کمی بهتر بود؛ Jev در زمان میانهٔ تصمیمگیری سریعتر بود و احتمالهایش برای تشخیص موارد نیازمند سؤال، اطلاعات مفیدی میدادند. این آزمایش محدود، دلیل انتخاب نقش مناسب برای هر مدل شد. از آن نمیتوان ضریب سرعتی عمومی یا وعدهٔ عملکرد بیخطا در همهی کلینیکها استخراج کرد.
نتیجهٔ مهمتر برای ما این بود که رتبهبندی مدلها با یک عدد دقت، بخشی از مسئله را پنهان میکند. دو مدل ممکن است تقریباً به یک اندازه درست جواب بدهند، اما یکی در موارد مبهم هم با همان ظاهر مطمئن پاسخ بدهد. برای خودکارسازی، دانستن اینکه کجا باید سؤال پرسید میتواند بهاندازهٔ درست انتخابکردن ارزش داشته باشد. این به معنی ناممکنبودن سنجش عدمقطعیت در LLMها نیست؛ دربارهٔ سیگنالی است که در مقایسهٔ مشخص ما در دسترس بود.
در نگاه کلی، این ابزارها مسئولیتهای مکملی دارند:
| بخش | سهم مناسب در یک دستیار |
|---|---|
| مدل زبانی | گفتوگو، توضیح، نوشتن و رسیدگی به پرسشهای باز |
| مدلی مانند Jev | داوری محدود میان پاسخهای مشخص، همراه با اطلاعات احتمالی |
| نرمافزار | کنترل دسترسی، اعتبارسنجی، محاسبه و ثبت نتیجهٔ واقعی |
این تقسیم مسئولیت به ما اجازه داده گفتوگو را طبیعی نگه داریم و تصمیم به انجام کار را دقیقتر بررسی کنیم. اگر دو مراجع همنام باشند، یک سؤال کوتاه از حدسزدن مفیدتر است. وقتی یک کار مجاز و برگشتپذیر انجام میشود، نتیجه و امکان برگرداندن آن دیده میشود. کارهای حساس هم تأیید خود را حفظ میکنند. بالا بودن احتمال، جای مجوز یا مسئولیت حرفهای را نمیگیرد.
منظورمان از ثبات، تضمین پاسخ یکسان در تکتک فراخوانیهای مدل نیست. رفتار قابلپیشبینی از قواعد روشن محصول میآید: اطلاعات ناکافی به سؤال منتهی شود، نبود دسترسی جلوی عمل را بگیرد و اعلام انجام کار به نتیجهٔ ثبتشده وابسته باشد. یک مدل احتمالی میتواند به چنین سیستمی کمک کند؛ تضمینهای نرمافزار باید همچنان مستقل از لحن پاسخ پابرجا بمانند.
بهبودهای این هفته هم فقط به افزودن Jev محدود نبودند. پاسخهای دستیار تدریجی نمایش داده میشوند، نتیجهٔ کار به رکورد مربوط وصل است و پیشنهادهای شروع گفتوگو با کار روزانهٔ هر فرد ارتباط دارند. در پرسشهای عددی، مثل میزان پُربودن برنامه، توضیح با عدد و منبع محاسبه همراه است. اینها کمک میکنند کاربر زودتر بفهمد چه اتفاقی افتاده و بتواند نتیجه را بررسی کند. سهم Jev در این مجموعه، بهترکردن تصمیمهای محدود و برخورد با ابهام است.
سرعت را نیز باید از دید همین کاربر سنجید. زمان رسیدن اولین جمله، زمان روشنشدن تصمیم و زمان تمامشدن کار، سنجههای متفاوتیاند. ظاهرشدن سریع متن بهتنهایی نشان نمیدهد عملیات سریع شده است. از طرف دیگر، هر بار انتظار طولانی در کاری که دهها بار تکرار میشود، هزینهٔ توجه دارد. پس کاهش تأخیر یک تصمیم کوچک، حتی بدون تغییر محسوس در کیفیت نثر، میتواند بهبود مهمی در تجربهٔ روزانه باشد.
برداشت دیگری که از این کار داریم، اهمیت قابلیت اصلاح در کنار دقت و سرعت است. هزینهٔ واقعی یک تصمیم اشتباه شامل زمانی است که کاربر صرف کشف و اصلاح آن میکند. به همین دلیل، هنگام ارزیابی یک دستیار باید هم خطای اقدام را شمرد، هم سؤالهای اضافی را، هم سهم کارهایی را که درست تمام میشوند. مدلی که همیشه سؤال میپرسد ممکن است خطای اقدام کمی داشته باشد، اما بار کار را به کاربر برگرداند. تعادل مناسب را باید با پیامد هر کار سنجید.
برای تیمهایی که یک LLM در محصولشان دارند، Jev میتواند در مسیریابی درخواست، دستهبندی، سنجش ابهام یا بررسی یک انتخاب مشخص مفید باشد. پرسش عملی این است که آیا در آن بخش، فضای پاسخ محدود است و دانستن عدمقطعیت میتواند رفتار محصول را بهتر کند. توضیح، نوشتن و مسئلههای باز همچنان به توانایی مدل زبانی نیاز دارند.
معیار ما برای سیمرغ این است که کاربر با زمان و توجه کمتر، کار درست را به پایان برساند؛ وقتی لازم است سؤال روشنی ببیند و بتواند نتیجه را بررسی یا اصلاح کند. قرارگرفتن Jev کنار مدل زبانی، برای ما قدمی در جهت همین معیار بوده است.